
4K双目+MANO手部位姿:VDEgo如何重新定义第一视角数据标准?
VIRDYN - VDEGO - DATA
无论VLA还是世界模型,两者正走向深度融合,而决定这场进化上限的,唯有高质量的数据底座。但高质量第一视角数据稀缺,根因不在“采不到”,而在“采不准、对不齐、标不出”。广州虚拟动力VDEgo把硬件选型、双目采集与数据处理工具链三位一体打通,构筑起难以复制的核心技术壁垒。
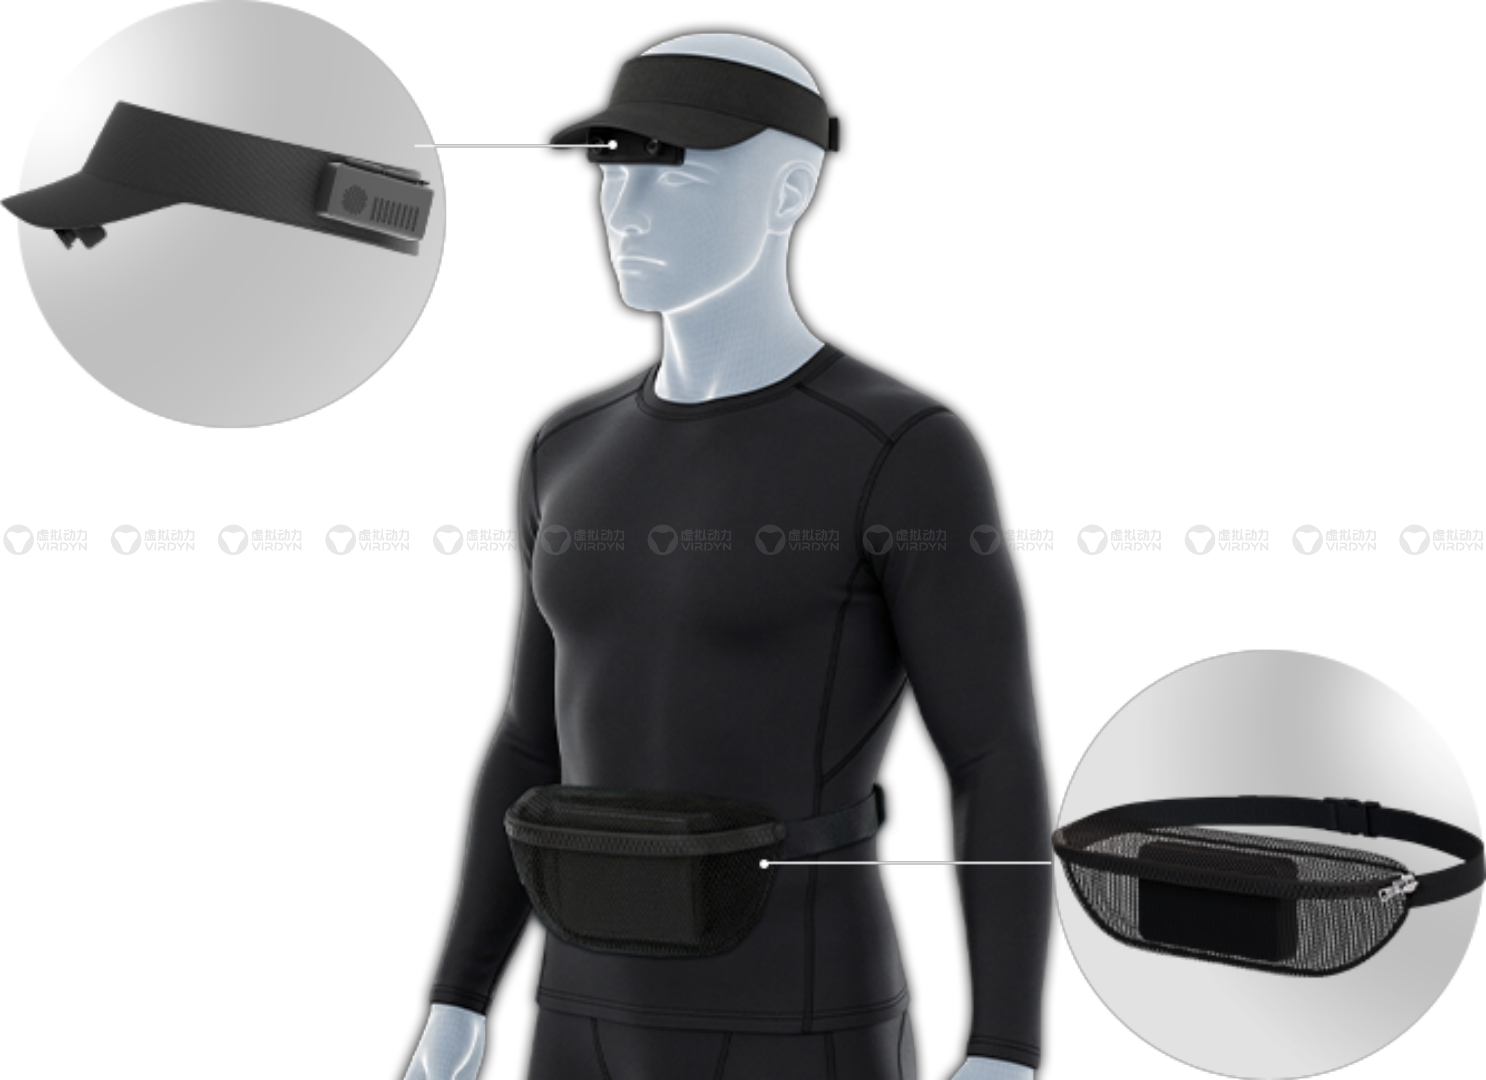
一、硬件选型:为第一视角而生的头戴式架构
相比固定机位与单目方案,ego坚定选择采取头戴式双目结构。只有贴近人眼的第一视角,才能对齐人类的操作逻辑和流程,让抓取、摆放、装配、折叠等精细的手部动作与SLAM轨迹解算相结合,输出精确的空间定位。设备还支持离线一键启停和在线远程控制,可以批量部署家居、办公、工业等场景的快速复用。
二、4K双目超清数据,看得更细节,更全面
双目相机的核心优势在于深度信息的完整获取。相比于单目方案,VDEgo以4K无损双目视频直接输出高精度深度信息与稳健三维结构,细节完整还原。在模态维度上,VDEgo交付“视觉+IMU+头部位姿+语音”全维度数据。而市面常规数据集多为单目,模态单一、缺少IMU与头部位姿同步、画质低下、细节丢失严重。同时,手部动作是VLA模型学习的核心要素之一。VDEgo采用MANO标准手部位姿输出方案,每帧提供完整的手部关节姿态真值,无需算法团队用开源模型反推。这意味着更低的误差累积和更高的标注效率,直接提升了模型对精细操作行为的理解能力。

三、工具链完善,从采到训的闭环
数据采集是第一步,数据处理能力才是决定数据集可用性的关键。虚拟动力自研“采-洗-切-标”全链路平台,采集端对接自研Ego设备统一入库;清洗端进行质量筛查、去噪与时序对齐;切片端按训练需求精准切割任务片段;标注端采用AI预标注+人工协同的双重保障机制,支持骨骼点、3D位姿、行为语义等专项标注。VDEgo还创新的推出了“固定相机+ego”融合方案,更补齐纯ego语义碎片化,还原“躯干—手臂—手指”层级化动作逻辑。模态数据支持 BVH、SMPL、JSON、CSV、LeRobot、MCAP 等主流格式,还附带完整说明文档,开箱即训。从原始数据到可训练数据集,全流程可控、可追溯。
VDEgo已建成超1000小时的多场景可交付真实数据集。可直接对接主流VLA模型训练框架。场景丰富度与专业度远超一般数据集。在具身智能的竞赛中,数据质量正在成为区分模型上限的关键变量。与其在自建采集方案上反复试错,不如将专业的事交给专业的人。VDEgo以自研硬件+全链路工具链+标准化交付,帮助团队快速获得高质量的第一视角训练数据,让算法迭代不再被数据瓶颈拖累。