
具身智能模型进阶,质量远比体量重要
VIRDYN - VDEGO - DATA
在具身智能模型训练领域,很多团队陷入“堆数据、堆算力”的误区,误以为数据体量越大,模型效果越好。但真实训练实践早已打破这一认知:数据体量不等于训练价值,数据质量才是决定模型准确率、泛化能力与稳定性的核心关键。

有实测训练数据佐证,高质量数据对模型性能的提升有着决定性作用。投入1万小时的高标准纯净具身数据进行训练,模型任务准确率大幅攀升,泛化能力显著增强,能够快速适配各类复杂场景。反观训练叠加1万小时瑕疵数据后,模型不仅没有迭代升级,反而出现性能回落、能力退化等问题,错误特征被固化,极大拖累模型落地效果,可见劣质数据不仅无效,更会成为迭代的致命短板。
当下市面通用数据集普遍存在诸多硬伤,难以满足高精度具身智能训练需求,成为模型进阶的桎梏。行业数据集缺乏统一标准,手部姿态数据不规范,需依靠算法反推,误差极大;数据模态单一,仅包含视觉信息,缺失IMU、头部位姿等核心同步数据,无法构建完整空间认知逻辑。同时,多数数据集采用单目低分辨率画质,场景细节严重缺失,标注浅显粗糙,没有结构化动作语义拆解。且场景高度同质化,集中于简单家庭日常场景,复用性极低,完全无法适配多样化、高精度的模型训练需求。
深耕具身数据领域的虚拟动力,直击行业痛点,打造全维度高标准优质数据集,为世界模型高效迭代赋能。数据集严格遵循MANO标准手部位姿规范,每帧均配备完整关节姿态真值,无需算法反推,从源头杜绝误差。依托多模态时空同步技术,实现视觉、IMU、头部位姿、语音数据全维度精准对齐,构建全方位、立体化的感知训练体系。
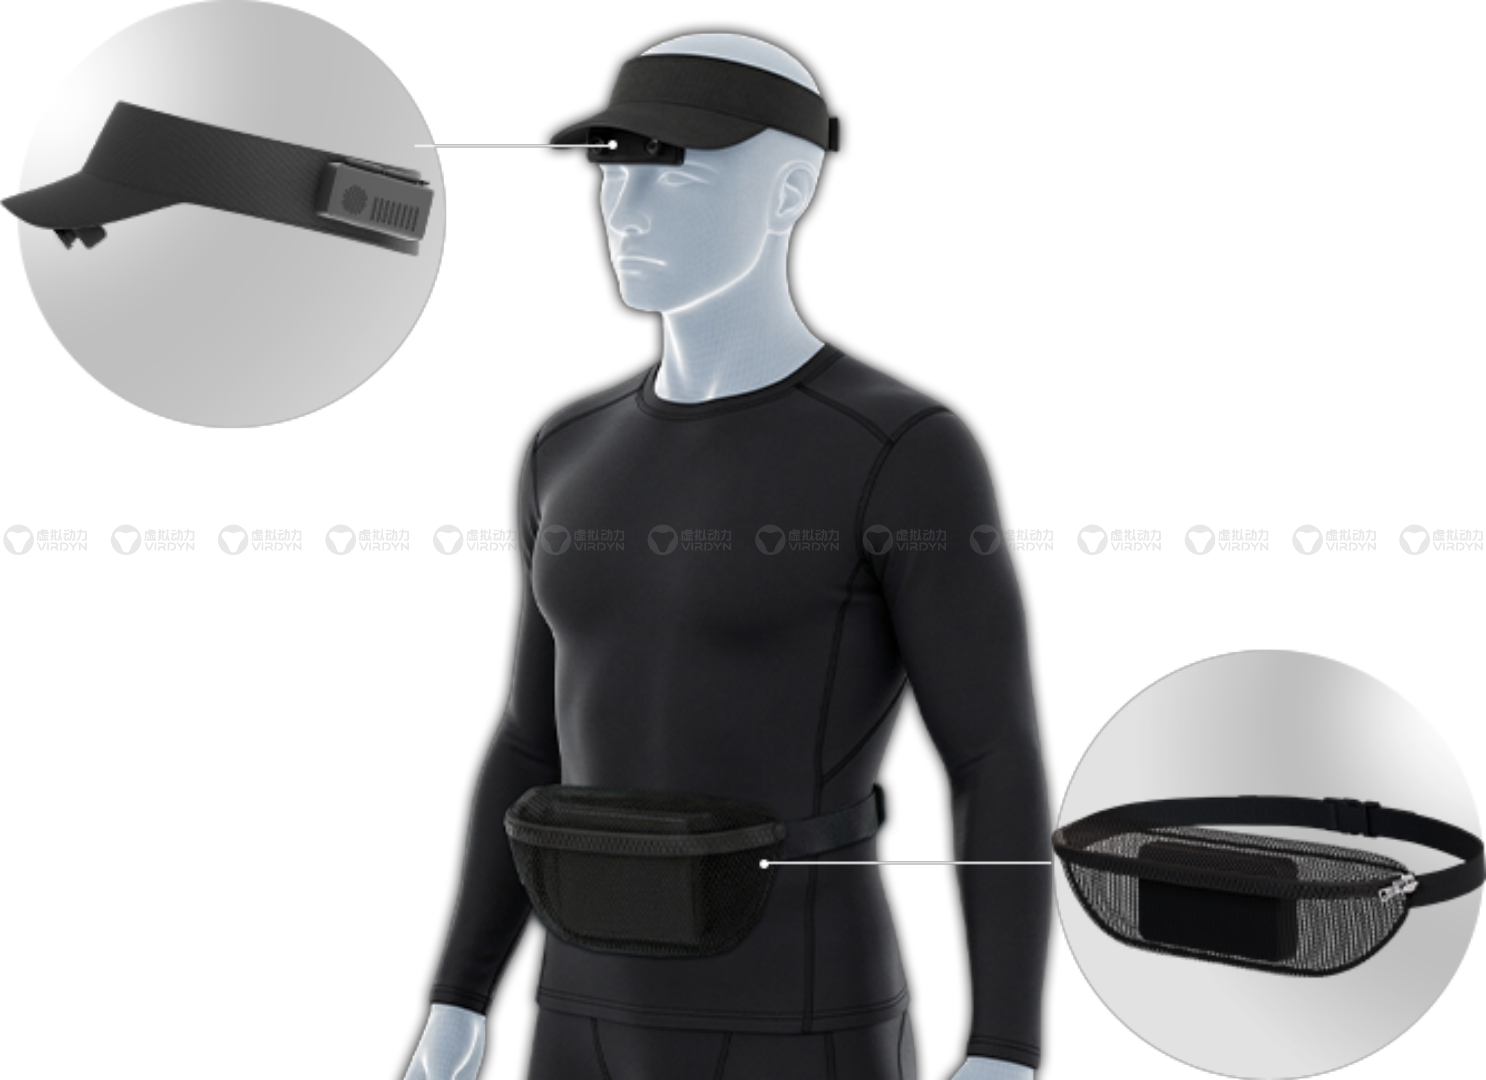
在画质与精度上,采用4K双目超清采集,完整还原高精度深度信息与场景细节。搭配精细化结构化标注,完成人物、动作、结果的全维度语义清洗,数据开箱即训、高效可用。同时支持定制化场景采集,可根据模型训练的差异化需求定向搭建数据集,彻底摆脱通用数据的场景局限。

算力决定训练速度,数据决定模型上限。虚拟动力以极致优质的具身数据集,摒弃无效数据堆砌,用精准、多维、专业的高质量数据,助力世界模型突破性能瓶颈,实现高精度、高泛化性的跨越式升级。